我们怎么给一支股票估值:十二个模型,一个数
 Allen Yan · · 7 分钟
目录
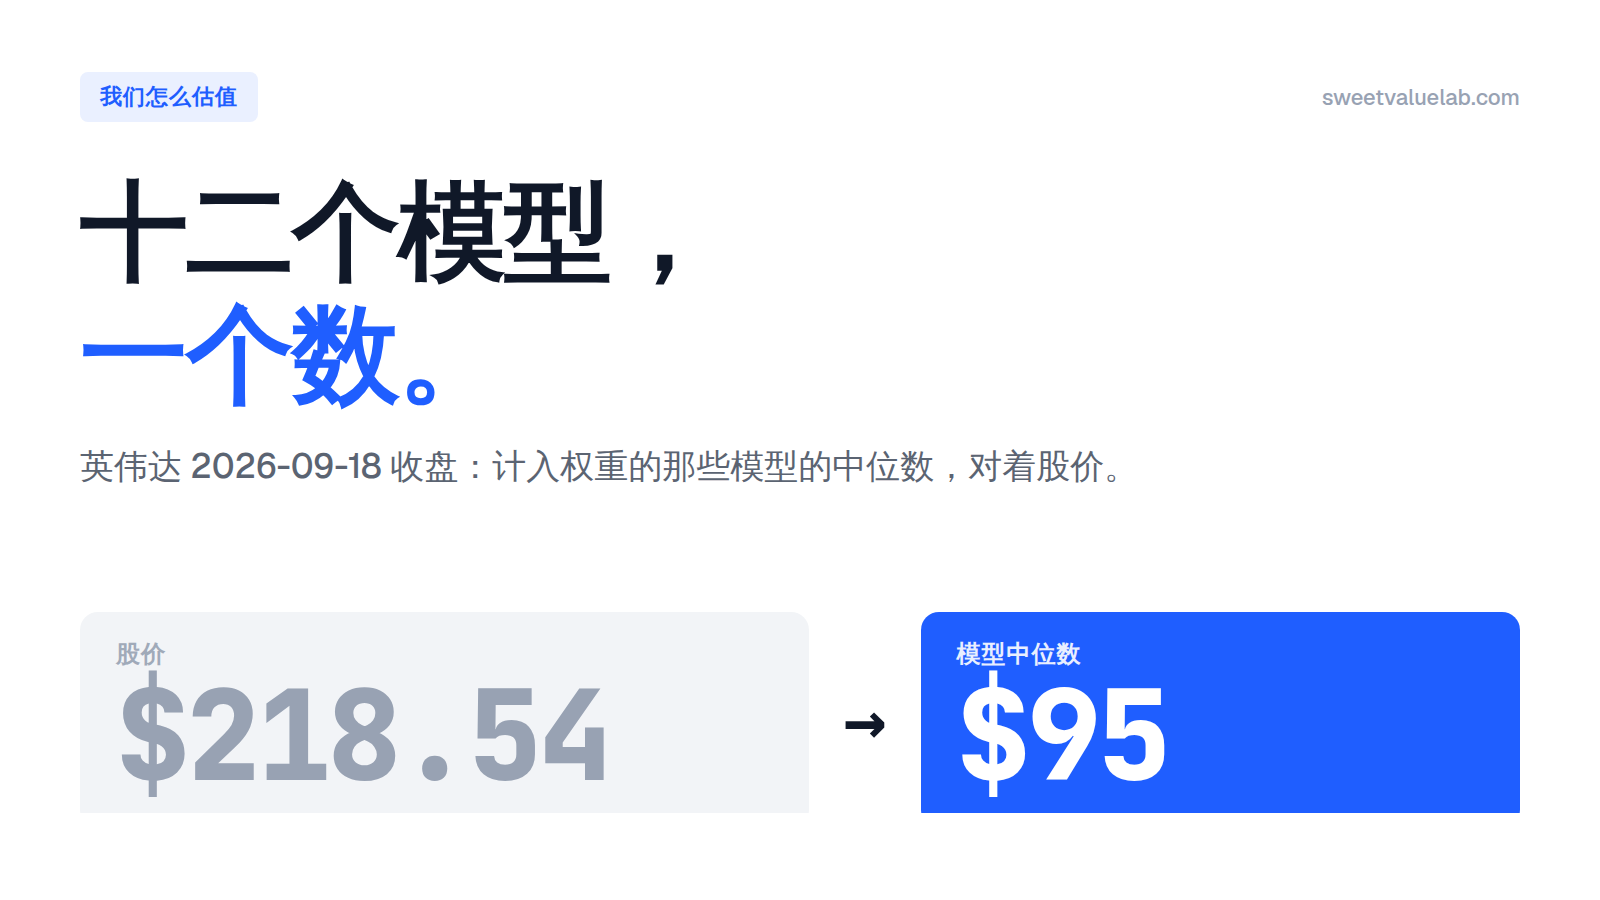
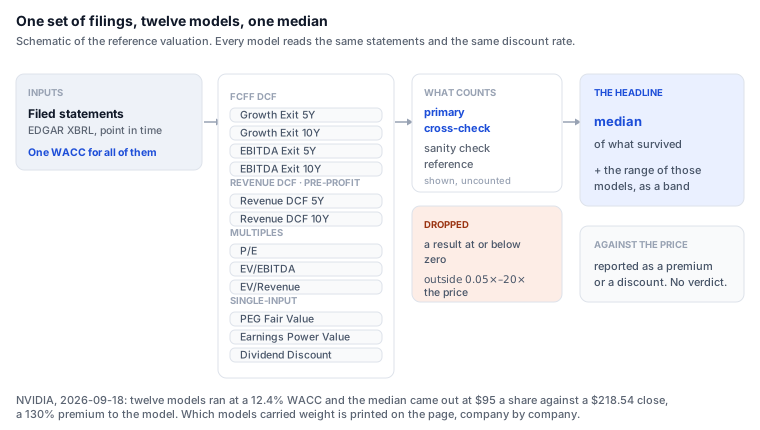
英伟达 2026 年 9 月 18 日收盘 $218.54。那天本站估值页顶上写的模型价值是每股 $95,股价比模型高 130%。这段代码是我写的,所以我想把那句话说准:$95 是十二个模型的中位数,它们跑在同一套已申报财报上、用同一个折现率,算完之后把没通过合理性检查的结果扔掉,剩下的取中位数。
这句话里有四个决定。哪十二个模型。一家具体的公司该算哪几个。12.4% 这个折现率从哪来。某个模型算出一个荒唐数字时会发生什么。这篇就按这个顺序讲这四件事。里面每一条都是代码里的常量或规则,整条流水线没有任何一步去问模型「你觉得呢」,同一套财报跑两遍,结果一模一样。
这些内容此前有一年多放在一个叫 /methodology 的页面上,用第三人称写的,读起来像一份规格说明。其实它本来就是另一种东西:我做过的一串选择,包括一开始做错的两个。那两个就是第一节。
一、最早顶上只放一个模型
第一版顶上放的是单一模型:五年期 FCFF 折现现金流、增长退出。这是投行分析师会搭的那个模型,所以让它代表全局,当时觉得说得过去。它从两个方向失效了。
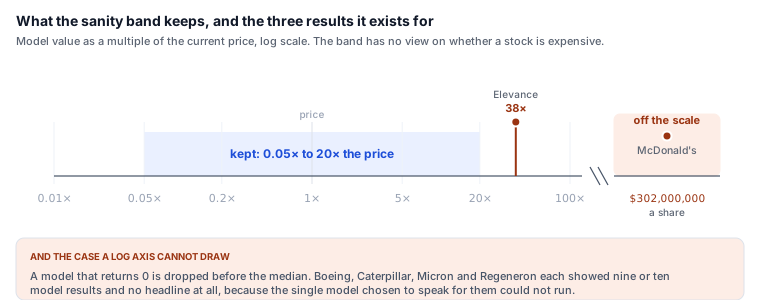
它返回 0 的时候,页面顶上什么都没有。波音、卡特彼勒、美光、再生元这四家,页面往下滚有九到十个模型结果,最上面是一片空白——因为被选来替它们发言的那一个模型跑不出来。
它炸掉的时候,页面顶上放的就是残骸。一个错的股数,或者给一门净利率 4% 的生意投出 70% 的预测利润率,都会径直穿过 DCF,从另一头变成一个每股价值。麦当劳那页顶上写的是每股 $302,000,000。Elevance 那页写的数字是它自己股价的 38 倍。两个都真的上线过,公开挂着,谁打开都能看见。
所以现在顶上放的是有权重的那些模型的中位数,并且在取中位数之前,用一条很宽的合理性带把残骸剔掉。这里用中位数是有原因的。均值会被那条带放过去的极端值拽走,而一个取决于「今晚跑得最差的那个模型」的头条数字,一文不值。
二、十二个模型
每个模型问的是同一家公司的不同问题。它们就是卖方或买方分析师会在 Excel 里搭的那些,这是故意的。这里没有什么独门方法。就是那一套标准模型,每晚在 518 家公司上按同样的规则跑一遍。
| 模型 | 它回答的问题 | 需要什么 |
|---|---|---|
| 增长退出 5Y | 五年的公司自由现金流值多少钱,之后按终值增速永续增长? | 现金流量表、WACC |
| 增长退出 10Y | 同上,十年 | 现金流量表、WACC |
| EBITDA 退出 5Y | 同样的五年,但第五年按 EBITDA 倍数把生意卖掉 | 现金流、EBITDA、WACC |
| EBITDA 退出 10Y | 同上,十年 | 现金流、EBITDA、WACC |
| 营收 DCF 5Y | 对亏钱的公司:如果利润率五年内收敛到行业水平,它值多少? | 营收路径、行业利润率 |
| 营收 DCF 10Y | 同上,十年 | 营收路径、行业利润率 |
| P/E | 按同业中位数 P/E,这家公司的盈利值多少钱? | EPS、同业组 |
| EV/EBITDA | 同样的问题,问在 EBITDA 上 | EBITDA、净债务、同业组 |
| EV/Revenue | 同样的问题,问在营收上 | 营收、净债务、同业组 |
| PEG 公允价值 | (盈利增速点数 + 股息率)× 明年 EPS | 增速预期、股息 |
| 盈利能力价值 EPV | 按当下的正常化盈利、假设永远零增长,它值多少? | 正常化 EBIT、WACC |
| 股息折现 DDM | 这条股息流按股权成本折现值多少? | 股息历史、股权成本 |
每个倍数模型都跑两条腿,历史(trailing)和前瞻(forward),再取平均。同业中位数取自数据源标注的该公司所属行业,这是一个实实在在的局限,留到第七节。
只有五个模型计入中位数的时候,十二个也照样全画在页面上。那一屏里最有用的东西是它们之间的离散度。十二个模型落在彼此 20% 以内,说明这家公司的价值大部分来自已经存在的现金流;散开三倍,说明价值取决于你认为哪个问题才是对的问题,而页面替你决定不了。
三、一家公司该算哪几个
任何模型开跑之前,先有一个分类器读这家公司的增速、利润率、股息率、盈利波动性和资产密度,把它归进八个原型之一:高增长、盈利性增长、成熟稳定、股息型、周期型、扭亏中、重资产、亏损中。页面会写出它用的是哪一个。
原型决定每个模型的角色。主模型和交叉验证的结果进中位数。合理性检查是单输入模型,留在屏幕上做参照。不适用的意思是这个模型对这家公司说不出任何诚实的话,于是根本不跑。几个具体的落法:
- 亏钱的公司,主模型是两个营收 DCF。把它当下的费用率照着往后推,只会把亏损永续下去。EPS ≤ 0 时 P/E 直接不适用。
- 成熟、增长慢的公司,EV/EBITDA 升为主模型。同一个倍数放在高增长公司上只是交叉验证。
- 股息型公司,股息折现模型带权重。其他公司它就是参考模型,画出来但不计入。
这些规则里最大的一条,来自一下午盯着保险公司看。银行、保险、资管公司本身就是一张资产负债表:它的收入是利息和保费,它的营业利润里面本来就含着利息,EBITDA 对它没有意义。把这种公司喂进公司层面的现金流模型,出来的是带美元符号的胡话——全池子里每一家保险公司和银行都是股价的 5 到 40 倍,Allstate、Arch、Progressive、Travelers 全在里面。所以对这些行业,四个 DCF、EPV 和 EV/EBITDA 一律标为不适用,头条数字退回盈利倍数。银行真正的答案是有形账面价值和它的回报率,这也是为什么银行有自己的体检板和自己的长文,而不是一个 DCF。
四、折现率从哪来
十二个模型里有七个需要折现率,而且七个用的是同一个。它是加权平均资本成本(WACC),按教科书的办法搭出来,然后被刻意压平。
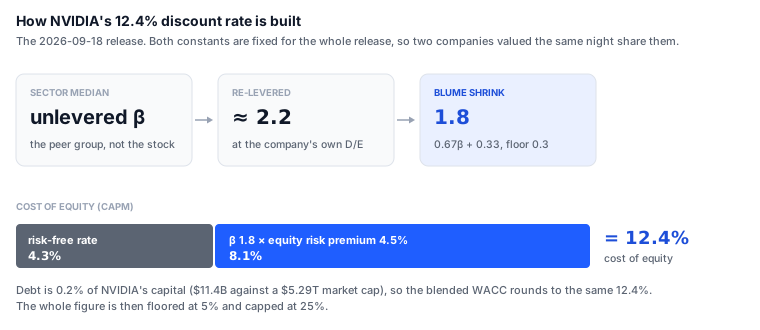
股权成本走 CAPM:无风险利率加上 beta 乘股权风险溢价。无风险利率用十年期美债的代理值,目前 4.3%,整版发布期间锁成一个常量,好让同一晚估的两家公司共享同一个。股权风险溢价取 4.5%,Damodaran 的隐含值,每年一月复核一次。
beta 是值得多说两句的那一块。单只股票自己回归出来的 beta 很吵,而它对最终价值的影响比几乎任何其他输入都大,所以引擎自下而上搭它:取行业中位数的无杠杆 beta,按这家公司自己的债务股本比重新加杠杆,再往 1 的方向收缩三分之二(0.67β + 0.33,老的 Blume 调整),下限 0.3。英伟达重新加杠杆后大约 2.2 的 beta,出来是 1.8。一家安静的公用事业 0.5 出来是 0.67。这个收缩让 518 家公司的折现率在夜与夜之间稳得多,代价是在 beta 真的极端的公司上会失准。
预测外面还套着三个夹子。它们是代码里的常量,对 518 家公司一视同仁:
- 增速被夹在每年 −10% 到 +30% 之间。
- 终值增速按原型给定:股息型、周期型、重资产 2.5%,成熟 3.0%,高增长 4.0%。
- 折现率和终值增速之间的差小于 1.5 个点时,永续增长公式作废,终值改用 20 倍退出倍数。因为
现金 /(r − g)在差 0.2 个点的时候会给出上千倍的倍数,而且不会报错。
最后整个 WACC 还有一个 5% 的地板和 25% 的天花板。
五、合理性带,以及承认自己算不出来的页面
一个模型结果要进中位数,得大于 0,并且落在当前股价的 0.05× 到 20× 之间。这条带宽得离谱,是故意的。它是个抓 bug 的网,对股票贵不贵没有任何看法:公允价值是股价的一半或者三倍,都毫发无伤地穿过去。
一个都没活下来的时候,页面就这么写。它印「没有头条模型价值」,说明加权模型要么什么都没返回、要么落在带外,然后照样把每一个模型的结果列在下面。该有数字的地方空着,这是一个诚实的输出。页面看起来不对的时候,我第一个看的也是这里。
六、为什么它永远不会说「买」
模型价值和股价之间的差,只被表述为相对模型的溢价或折价,词汇表就这么大。公开接口在数据送到浏览器之前会把内部那个 verdict 字段剥掉。像「低估」这样的词是在替你决定该拿钱做什么,而本站不知道你的税务状况、你的期限,也不知道你手上还有什么。
七、十二个模型仍然做不到的事
- 它们不是十二张独立的选票。 一个 WACC 喂给其中七个,一套已申报财报喂给全部十二个。股数错了的时候,十二个一起错,而中位数会把这件事藏得很漂亮。
- 同业组只是一个行业标签。 同业中位数来自数据源的行业分类。它会把支付网络和保险经纪放进银行的邻居里,标签错了,所有倍数模型跟着错。
- 基准年只是一年。 一次资本开支高峰、一次罢工、一笔一次性减值、一个疫情年份,会扭曲所有从它出发的模型。财务页给出八年,就是让你先看清最新那一年是什么成色的一年。
- 它是描述,而且日期很重要。 价格是最近收盘,报表是最新申报。这里没有任何东西在预测季度,今晚算出来的模型价值对明天开盘没有看法。
如果十二个模型吵得很凶,更有用的做法通常是把算术倒过来,问这个价格本身假定了什么,也就是反向 DCF。如果这家公司是银行、REIT 或软件公司,行业长文用的是那些行业真正被定价的口径。如果它的几块生意差别太大、一个倍数装不下,特斯拉的分部估值就是手工做这件事的样子。
至于报表本身从哪来、要做些什么才能让八年的申报排成八行可比的数据,是下一篇的题目。
订阅周报
每周一封英文周报:本周的 13F 持仓申报、内部人交易、财报,以及站内的新研究。不需要注册。
更多文章
- Anthropic 三季度收入 168 亿美元:投资者日透露的数字
- DCF 估值入门:一家便利店到底值多少钱
- 美股 101:现金流折现估值法
- 10 年期美债如何影响本站的每一个估值
- 达美 vs 美联航:把财报摆在一起看
- Anthropic 招股书拆解:420 亿亏损与 5180 亿算力账单
- 穿越周期的成长:Zoom 的 AI 重生与估值错配修复
- 期权:从原理到第一笔交易
- 谁在持有这只股票:13F 怎么读
- 市场情绪表盘怎么读:一个恐惧读数是怎么算出来的
- 市场宽度:指数在涨,多数股票在跌
- 这些数字从哪来:申报文件,以及它们何时公开
- 把特斯拉拆开:三种情景下的分部估值
- 反向 DCF 怎么读:股价里藏着的增长率
- 银行怎么估值,一步一步来:P/TBV、ROTCE 和那条线
- REIT 怎么估值,一步一步来:FFO、P/FFO 和收益率利差
- 软件公司怎么估值,一步一步来:Rule of 40 和股票的代价
- 总回报 vs 价格回报:股价图漏掉了什么
- 回测告诉不了你的五件事